<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://androidreverser-test.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://androidreverser-test.github.io/" rel="alternate" type="text/html" /><updated>2026-09-15T16:22:05+00:00</updated><id>https://androidreverser-test.github.io/feed.xml</id><title type="html">AI逆向</title><subtitle>使用AI做逆向分析</subtitle><entry><title type="html">a2 生成算法说明（脱敏版）</title><link href="https://androidreverser-test.github.io/2026/09/16/a2-algorithm-sanitized.html" rel="alternate" type="text/html" title="a2 生成算法说明（脱敏版）" /><published>2026-09-16T00:00:00+00:00</published><updated>2026-09-16T00:00:00+00:00</updated><id>https://androidreverser-test.github.io/2026/09/16/a2-algorithm-sanitized</id><content type="html" xml:base="https://androidreverser-test.github.io/2026/09/16/a2-algorithm-sanitized.html"><![CDATA[<h2 id="1-文档范围">1. 文档范围</h2>

<p>本文描述 a2 从请求字段到最终小写十六进制字符串的完整行为级算法。</p>

<p>本文有意隐藏以下信息：</p>

<ul>
  <li>内部函数名称及函数偏移。</li>
  <li>实际 HMAC key、key source、B16、MASK16 和固定 profile 字节。</li>
  <li>样例请求中的设备标识、业务字段值、中间 digest 和最终输出值。</li>
</ul>

<p>本文保留 APK 载荷恢复所需的偏移、长度、容器格式和白盒表布局。实际运行时常量应作为
独立的二进制 profile 注入实现，不应直接写入公开文档。</p>

<h2 id="2-总体数据流">2. 总体数据流</h2>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>request fields
    |
    +--&gt; canonical request message
    |
    +--&gt; device id (field a1) + profile key material
             |
             v
        36-byte HMAC key
             |
             v
HMAC-SHA1(key, message) -&gt; 20-byte digest
             |
             +--&gt; digest[0:16] = data16
             |
             v
      white-box transform(data16, table profile)
             |
             v
          A16 (16 bytes)
             |
             v
  a2 core(data16, A16, B16, MASK16)
             |
             v
          mid16
             |
             v
  caller finalization(mid16, MASK16, fixed byte)
             |
             v
          raw16
             |
             v
      lowercase hexadecimal (32 chars)
</code></pre></div></div>

<p>其中，a2 主计算实际只消费 HMAC 输出的前 16 字节。剩余 4 字节仍属于 HMAC-SHA1 的
标准输出，但不进入白盒和 a2 字节循环。</p>

<h2 id="3-输入分类">3. 输入分类</h2>

<h3 id="31-请求字段">3.1 请求字段</h3>

<p>请求由两部分组成：</p>

<ol>
  <li>固定格式的请求前缀，包括 HTTP 方法、路径和规范化 query 参数。</li>
  <li>按协议固定字段顺序序列化的紧凑 JSON。</li>
</ol>

<p>字段名属于业务协议，例如 <code class="language-plaintext highlighter-rouge">a0</code>、<code class="language-plaintext highlighter-rouge">a1</code>、<code class="language-plaintext highlighter-rouge">a3</code>、<code class="language-plaintext highlighter-rouge">a4</code>、<code class="language-plaintext highlighter-rouge">a5</code>、<code class="language-plaintext highlighter-rouge">a6</code>、<code class="language-plaintext highlighter-rouge">a7</code>、<code class="language-plaintext highlighter-rouge">a8</code>、<code class="language-plaintext highlighter-rouge">a9</code>、
<code class="language-plaintext highlighter-rouge">a10</code> 和 <code class="language-plaintext highlighter-rouge">x0</code>。本文不记录这些字段的实际值。</p>

<p>JSON 序列化要求：</p>

<ul>
  <li>不插入空格和换行。</li>
  <li>对象使用 <code class="language-plaintext highlighter-rouge">,</code> 和 <code class="language-plaintext highlighter-rouge">:</code> 作为紧凑分隔符。</li>
  <li>保持协议规定的字段顺序，不按字典序重新排序已有字段。</li>
  <li>需要 ASCII 兼容输出时使用 JSON ASCII escaping；非 ASCII 协议实现应明确采用的字节编码。</li>
  <li>最终 HMAC 输入是 message 的原始字节，不是十六进制文本或 Base64 文本。</li>
</ul>

<p>对当前 trace 样例，完整 message 长度为 1120 字节。其它请求的长度可以不同，HMAC
实现不依赖该固定长度。</p>

<h3 id="32-设备标识">3.2 设备标识</h3>

<p>字段 <code class="language-plaintext highlighter-rouge">a1</code> 同时参与：</p>

<ul>
  <li>JSON message 的构造。</li>
  <li>36 字节 HMAC key 的派生。</li>
</ul>

<p>当前二进制 profile 要求用于 key 派生的 device id 为 36 字节 ASCII 数据。实现应在进入
key loop 前验证长度，不应静默截断或补零。</p>

<h3 id="33-二进制-profile">3.3 二进制 profile</h3>

<p>以下参数是受保护二进制的固定 profile，而不是随 message 变化的中间状态：</p>

<table>
  <thead>
    <tr>
      <th>参数</th>
      <th style="text-align: right">规格</th>
      <th>用途</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">KEY_SOURCE_EFFECTIVE</code></td>
      <td style="text-align: right">36 bytes</td>
      <td>key loop 中最终会保留下来的 source 字节</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">KEY_XOR_BYTE</code></td>
      <td style="text-align: right">1 byte</td>
      <td>key loop 的固定 XOR 操作数</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">B16_PROFILE</code></td>
      <td style="text-align: right">16 bytes</td>
      <td>a2 core 的第二个字节操作数</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">MASK16_PROFILE</code></td>
      <td style="text-align: right">16 bytes</td>
      <td>a2 core 和 finalize 使用的 mask</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">FINAL_FIXED_BYTE</code></td>
      <td style="text-align: right">1 byte</td>
      <td>finalize 中的 AND/XOR 操作数</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">PERM_PROFILE</code></td>
      <td style="text-align: right">16 entries</td>
      <td>白盒轮间字节置换</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">KT_PROFILE</code></td>
      <td style="text-align: right">16 x 16 x 32-bit</td>
      <td>白盒轮内 key lookup</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">NIB_PROFILE</code></td>
      <td style="text-align: right">16 x 16 x 8-bit</td>
      <td>白盒半字节混合</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">KF_PROFILE</code></td>
      <td style="text-align: right">16 x 16 x 8-bit</td>
      <td>白盒末轮 lookup</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">WB_TABLE</code></td>
      <td style="text-align: right"><code class="language-plaintext highlighter-rouge">0x2E000</code> bytes</td>
      <td>白盒主表</td>
    </tr>
  </tbody>
</table>

<p>本文不列出这些 profile 的实际字节值。</p>

<h2 id="4-36-字节-hmac-key-派生">4. 36 字节 HMAC key 派生</h2>

<h3 id="41-有效算法">4.1 有效算法</h3>

<p>原生实现使用一个 64 字节 source、一个 36 字节 device id 和一个 36 字节输出缓冲区。
循环把 source 与 device id 按 36 字节周期异或：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>OUTPUT = byte[0x24]

for i = 0 .. 0x3F:
    j = i mod 0x24
    OUTPUT[j] = SOURCE[i] XOR DEVICE_ID[j] XOR KEY_XOR_BYTE
</code></pre></div></div>

<p>这里的 <code class="language-plaintext highlighter-rouge">0x24</code> 是 36，<code class="language-plaintext highlighter-rouge">0x3F</code> 是最后一个循环索引 63。</p>

<p>因为循环次数 64 大于输出长度 36，第二遍会覆盖输出的前 28 字节。因此最终输出只
依赖：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>SOURCE[0x24:0x40] followed by SOURCE[0x1C:0x24]
</code></pre></div></div>

<p>这 36 个有效 source 字节在实现中可作为 <code class="language-plaintext highlighter-rouge">KEY_SOURCE_EFFECTIVE</code> 注入，从而避免保存
不会影响最终结果的前 28 个 source 字节。</p>

<h3 id="42-脱敏实现接口">4.2 脱敏实现接口</h3>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">derive_key36</span><span class="p">(</span><span class="n">device_id</span><span class="p">,</span> <span class="n">key_source_effective</span><span class="p">,</span> <span class="n">key_xor_byte</span><span class="p">):</span>
    <span class="n">require</span> <span class="nb">len</span><span class="p">(</span><span class="n">device_id</span><span class="p">)</span> <span class="o">==</span> <span class="mh">0x24</span>
    <span class="n">require</span> <span class="nb">len</span><span class="p">(</span><span class="n">key_source_effective</span><span class="p">)</span> <span class="o">==</span> <span class="mh">0x24</span>

    <span class="c1"># Reconstruct any 64-byte source whose overwritten prefix is irrelevant.
</span>    <span class="n">source64</span> <span class="o">=</span> <span class="p">(</span><span class="sa">b</span><span class="s">"</span><span class="se">\x00</span><span class="s">"</span> <span class="o">*</span> <span class="mh">0x1C</span>
                <span class="o">+</span> <span class="n">key_source_effective</span><span class="p">[</span><span class="o">-</span><span class="mi">8</span><span class="p">:]</span>
                <span class="o">+</span> <span class="n">key_source_effective</span><span class="p">[:</span><span class="mh">0x1C</span><span class="p">])</span>

    <span class="n">output</span> <span class="o">=</span> <span class="nb">bytearray</span><span class="p">(</span><span class="mh">0x24</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">source_byte</span> <span class="ow">in</span> <span class="nb">enumerate</span><span class="p">(</span><span class="n">source64</span><span class="p">):</span>
        <span class="n">j</span> <span class="o">=</span> <span class="n">i</span> <span class="o">%</span> <span class="mh">0x24</span>
        <span class="n">output</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="n">source_byte</span> <span class="o">^</span> <span class="n">device_id</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="o">^</span> <span class="n">key_xor_byte</span>
    <span class="k">return</span> <span class="nb">bytes</span><span class="p">(</span><span class="n">output</span><span class="p">)</span>
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">key_source_effective</code> 和 <code class="language-plaintext highlighter-rouge">key_xor_byte</code> 是二进制 profile，不是从本文恢复的公开常量。</p>

<h2 id="5-hmac-sha1">5. HMAC-SHA1</h2>

<h3 id="51-hmac-结构">5.1 HMAC 结构</h3>

<p>36 字节 key 小于 SHA-1 的 64 字节 block size，因此不需要先做 key hash。标准 HMAC
结构为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>ipad = 64 bytes of 0x36
opad = 64 bytes of 0x5C

inner = SHA1((key padded with zeros to 64 bytes XOR ipad) || message)
outer = SHA1((key padded with zeros to 64 bytes XOR opad) || inner)
digest20 = outer
</code></pre></div></div>

<h3 id="52-sha-1-block-processing">5.2 SHA-1 block processing</h3>

<p>实现可以使用标准库，也可以使用与原生 trace 等价的纯 Python 实现。纯实现应遵守：</p>

<ol>
  <li>message 按字节计算 bit length。</li>
  <li>追加一个 <code class="language-plaintext highlighter-rouge">0x80</code>。</li>
  <li>追加零字节，直到长度模 64 等于 56。</li>
  <li>以大端 64-bit 写入原始 bit length。</li>
  <li>每个 64 字节 block 解析为 16 个大端 32-bit word。</li>
  <li>扩展到 80 个 word：</li>
</ol>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>W[t] = rol32(W[t-3] XOR W[t-8] XOR W[t-14] XOR W[t-16], 1)
</code></pre></div></div>

<ol>
  <li>使用 SHA-1 的四组标准 round function 和标准 round constant。</li>
  <li>所有加法在 32-bit 模空间内进行。</li>
  <li>最终按大端顺序输出 5 个 32-bit state word，即 20 字节 digest。</li>
</ol>

<h2 id="6-从-apk-恢复白盒表">6. 从 APK 恢复白盒表</h2>

<p>本节的 APK 参数不脱敏。</p>

<h3 id="61-外层-raw-deflate">6.1 外层 raw DEFLATE</h3>

<p>受保护 APK 中的白盒载荷位于：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>file offset = 0x3DE254
file size   = 0x2927A
</code></pre></div></div>

<p>原生代码先将文件偏移按页对齐：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>aligned file offset = 0x3DE000
in-page delta       = 0x254
mapped length       = 0x28FE5
payload address     = mapped_base + 0x254
</code></pre></div></div>

<p>从 <code class="language-plaintext highlighter-rouge">0x3DE254</code> 开始读取 <code class="language-plaintext highlighter-rouge">0x2927A</code> 字节后，使用 raw DEFLATE 解压，即 zlib <code class="language-plaintext highlighter-rouge">wbits=-15</code>：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">outer_payload</span> <span class="o">=</span> <span class="n">apk</span><span class="p">[</span><span class="mh">0x3DE254</span><span class="p">:</span><span class="mh">0x3DE254</span> <span class="o">+</span> <span class="mh">0x2927A</span><span class="p">]</span>
<span class="n">xbt</span> <span class="o">=</span> <span class="n">zlib</span><span class="p">.</span><span class="n">decompress</span><span class="p">(</span><span class="n">outer_payload</span><span class="p">,</span> <span class="o">-</span><span class="mi">15</span><span class="p">)</span>
</code></pre></div></div>

<h3 id="62-xbt-容器">6.2 <code class="language-plaintext highlighter-rouge">.XBT</code> 容器</h3>

<p>外层解压结果以 28 字节头开始：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>offset +0x00: 4-byte magic, expected `.XBT`
offset +0x04: 32-bit little-endian version, expected 1
offset +0x08: 32-bit little-endian packed size, expected 0x2925E
offset +0x0C: 32-bit little-endian unpacked size, expected 0x2E000
offset +0x10: profile tag/check field
offset +0x14: profile tag/check field
offset +0x18: reserved field
offset +0x1C: inner zlib stream
</code></pre></div></div>

<p>因此内层数据范围为：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">packed</span> <span class="o">=</span> <span class="n">xbt</span><span class="p">[</span><span class="mh">0x1C</span><span class="p">:</span><span class="mh">0x1C</span> <span class="o">+</span> <span class="mh">0x2925E</span><span class="p">]</span>
<span class="n">decoded</span> <span class="o">=</span> <span class="n">zlib</span><span class="p">.</span><span class="n">decompress</span><span class="p">(</span><span class="n">packed</span><span class="p">)</span>
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">decoded</code> 必须正好为 <code class="language-plaintext highlighter-rouge">0x2E000</code> 字节。</p>

<h3 id="63-表区最终化">6.3 表区最终化</h3>

<p>内层 zlib 输出还没有成为白盒运行时实际读取的表。调用方对每个字节执行同一个 XOR：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">WB_TABLE</span> <span class="o">=</span> <span class="nb">bytes</span><span class="p">(</span><span class="n">value</span> <span class="o">^</span> <span class="mh">0x61</span> <span class="k">for</span> <span class="n">value</span> <span class="ow">in</span> <span class="n">decoded</span><span class="p">)</span>
</code></pre></div></div>

<p>最终 <code class="language-plaintext highlighter-rouge">WB_TABLE</code> 长度仍为 <code class="language-plaintext highlighter-rouge">0x2E000</code>。实现应检查 <code class="language-plaintext highlighter-rouge">.XBT</code> magic、版本、packed size、
unpacked size 和最终长度，避免把错误 APK 或错误压缩层静默当作表使用。</p>

<h2 id="7-白盒-a16-变换">7. 白盒 A16 变换</h2>

<h3 id="71-输入和置换">7.1 输入和置换</h3>

<p>白盒阶段输入为 <code class="language-plaintext highlighter-rouge">data16</code>，长度必须为 16 字节。当前 profile 使用一个 16-entry 字节
置换表 <code class="language-plaintext highlighter-rouge">PERM_PROFILE</code>：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">permute</span><span class="p">(</span><span class="n">value16</span><span class="p">):</span>
    <span class="k">return</span> <span class="nb">bytes</span><span class="p">(</span><span class="n">value16</span><span class="p">[</span><span class="n">PERM_PROFILE</span><span class="p">[</span><span class="n">i</span><span class="p">]]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">16</span><span class="p">))</span>
</code></pre></div></div>

<p>先执行一次置换，然后执行 9 个轮：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">x</span> <span class="o">=</span> <span class="n">permute</span><span class="p">(</span><span class="n">data16</span><span class="p">)</span>
<span class="k">for</span> <span class="n">round_index</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">9</span><span class="p">):</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">round_body</span><span class="p">(</span><span class="n">WB_TABLE</span><span class="p">,</span> <span class="n">round_index</span><span class="p">,</span> <span class="n">x</span><span class="p">)</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">permute</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
</code></pre></div></div>

<h3 id="72-轮内四组查表">7.2 轮内四组查表</h3>

<p>每轮将 16 字节分成 4 组，每组 4 字节。对组 <code class="language-plaintext highlighter-rouge">g</code>、组内位置 <code class="language-plaintext highlighter-rouge">k</code>：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>i = 4*g + k
b = x[i]
table_offset = 0xA000 + round_index*0x4000 + g*0x1000 + k*0x400 + b*4
v[k] = load_i32_le(WB_TABLE, table_offset) XOR K(round_index, i, b)
</code></pre></div></div>

<p>其中 <code class="language-plaintext highlighter-rouge">K</code> 由 16 x 16 的 32-bit profile 表计算：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>idx = round_index + i + b + 1
q   = (round_index * i * b) mod 16
r   = (idx * 0x44F + q) mod 16
c   = (idx * 0x70B + q) mod 16
K   = KT_PROFILE[r][c]
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">load_i32_le</code> 的结果按有符号或无符号读取都不会改变最终 32-bit XOR 位模式，建议实现
统一使用 masked 32-bit 整数。</p>

<h3 id="73-半字节混合">7.3 半字节混合</h3>

<p>每组得到四个 32-bit word <code class="language-plaintext highlighter-rouge">a,b,c,d</code>。对每个字节位置 <code class="language-plaintext highlighter-rouge">p=0..3</code>，从四个 word 提取
对应的高、低半字节：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>hi_p(w) = (w &gt;&gt; (8*p + 4)) &amp; 0xF
lo_p(w) = (w &gt;&gt; (8*p    )) &amp; 0xF
</code></pre></div></div>

<p>使用 <code class="language-plaintext highlighter-rouge">NIB_PROFILE</code> 完成两层查表：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>hi = NIB_PROFILE[
       NIB_PROFILE[hi_p(a)][hi_p(b)]
    ][
       NIB_PROFILE[hi_p(c)][hi_p(d)]
    ]

lo = NIB_PROFILE[
       NIB_PROFILE[lo_p(a)][lo_p(b)]
    ][
       NIB_PROFILE[lo_p(c)][lo_p(d)]
    ]

group_out[3-p] = (hi &lt;&lt; 4) | lo
</code></pre></div></div>

<p>这里的 <code class="language-plaintext highlighter-rouge">3-p</code> 是实际输出顺序的一部分，不能改为 <code class="language-plaintext highlighter-rouge">p</code>。</p>

<h3 id="74-末轮">7.4 末轮</h3>

<p>9 个轮体和轮间置换完成后，执行一个独立的 16 x 256 字节末轮表：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>for i = 0 .. 15:
    b = x[i]
    table_byte = WB_TABLE[0x9000 + i*0x100 + b]

    idx = 9 + i + b + 1
    q   = (9 * i * b) mod 16
    r   = (idx * 0x44F + q) mod 16
    c   = (idx * 0x70B + q) mod 16
    x[i] = table_byte XOR KF_PROFILE[r][c]
</code></pre></div></div>

<p>变换结果 <code class="language-plaintext highlighter-rouge">x</code> 即 <code class="language-plaintext highlighter-rouge">A16</code>，长度为 16 字节。</p>

<h3 id="75-白盒表布局">7.5 白盒表布局</h3>

<p><code class="language-plaintext highlighter-rouge">WB_TABLE</code> 中与 a2 变换相关的区域为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>0x9000 .. 0x9FFF
    末轮 16 x 256 字节表

0xA000 + round*0x4000 + group*0x1000 + k*0x400
    9 轮 x 4 组 x 4 张 256-entry 32-bit 表
</code></pre></div></div>

<p>轮体表从 <code class="language-plaintext highlighter-rouge">0xA000</code> 开始，覆盖到 <code class="language-plaintext highlighter-rouge">0x2E000</code> 末尾。表前部可能包含容器或运行时保留区域，
不要把整个 <code class="language-plaintext highlighter-rouge">0x2E000</code> 当作一个线性 lookup 表。</p>

<h2 id="8-a2-core">8. a2 core</h2>

<h3 id="81-输入">8.1 输入</h3>

<p>a2 core 接收四个 16 字节输入：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">data16</code>：HMAC digest 的前 16 字节。</li>
  <li><code class="language-plaintext highlighter-rouge">A16</code>：白盒阶段输出。</li>
  <li><code class="language-plaintext highlighter-rouge">B16_PROFILE</code>：固定 VM profile。</li>
  <li><code class="language-plaintext highlighter-rouge">MASK16_PROFILE</code>：固定 VM profile。</li>
</ul>

<h3 id="82-字节公式">8.2 字节公式</h3>

<p>所有运算按 8-bit 处理：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mid[i] = MASK16_PROFILE[i]
         XOR B16_PROFILE[i]
         XOR ((data16[i] + A16[i]) mod 256)
</code></pre></div></div>

<p>输出 <code class="language-plaintext highlighter-rouge">mid16</code> 长度为 16 字节。这里的加法不是 32-bit 加法；只保留低 8 位。</p>

<h2 id="9-调用方-finalize">9. 调用方 finalize</h2>

<p>finalize 使用 <code class="language-plaintext highlighter-rouge">mid16</code>、<code class="language-plaintext highlighter-rouge">MASK16_PROFILE</code> 和一个固定的 profile 字节。令：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>m = MASK16_PROFILE
k = FINAL_FIXED_BYTE
</code></pre></div></div>

<p>则：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>f9  = mid[0] XOR mid[7] XOR m[0] XOR 1
f10 = mid[1] XOR mid[6] XOR m[1]
f11 = mid[2] XOR mid[5] XOR m[2]
f12 = mid[3] XOR mid[4] XOR m[3]
f13 = mid[3] XOR mid[4] XOR m[4]
f14 = (m[5] XOR mid[4] XOR mid[5]) AND k
t   = f14 XOR k
f15 = (m[6] XOR mid[6] XOR mid[5]) OR t
f8  = f15 XOR t
</code></pre></div></div>

<p>最终 16 字节按以下顺序拼接：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>raw16 = mid[0:8] || f8 || f9 || f10 || f11 || f12 || f13 || f14 || f15
</code></pre></div></div>

<p>每个中间量均截断为 8-bit。<code class="language-plaintext highlighter-rouge">mid[8:16]</code> 不直接原样保留，而是由 <code class="language-plaintext highlighter-rouge">f8..f15</code> 重写。</p>

<h2 id="10-十六进制输出">10. 十六进制输出</h2>

<p>最终格式化只是逐字节输出小写 <code class="language-plaintext highlighter-rouge">%02x</code>：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">hex_output</span> <span class="o">=</span> <span class="n">raw16</span><span class="p">.</span><span class="nb">hex</span><span class="p">()</span>
</code></pre></div></div>

<p>因此：</p>

<ul>
  <li>输入长度为 16 字节。</li>
  <li>输出长度固定为 32 个 ASCII 字符。</li>
  <li>不添加前缀、空格、换行或大写字母。</li>
</ul>

<h2 id="11-脱敏版端到端伪代码">11. 脱敏版端到端伪代码</h2>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">a2_generate</span><span class="p">(</span><span class="n">fields</span><span class="p">,</span> <span class="n">profile</span><span class="p">,</span> <span class="n">apk_bytes</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="c1"># 1. Build the canonical message.
</span>    <span class="n">message</span> <span class="o">=</span> <span class="n">build_canonical_message</span><span class="p">(</span><span class="n">fields</span><span class="p">)</span>

    <span class="c1"># 2. Derive the 36-byte HMAC key from field a1.
</span>    <span class="n">device_id</span> <span class="o">=</span> <span class="n">ascii_bytes</span><span class="p">(</span><span class="n">fields</span><span class="p">[</span><span class="s">"a1"</span><span class="p">])</span>
    <span class="n">hmac_key</span> <span class="o">=</span> <span class="n">derive_key36</span><span class="p">(</span>
        <span class="n">device_id</span><span class="p">,</span>
        <span class="n">profile</span><span class="p">.</span><span class="n">key_source_effective</span><span class="p">,</span>
        <span class="n">profile</span><span class="p">.</span><span class="n">key_xor_byte</span><span class="p">,</span>
    <span class="p">)</span>

    <span class="c1"># 3. HMAC-SHA1.
</span>    <span class="n">digest20</span> <span class="o">=</span> <span class="n">hmac_sha1</span><span class="p">(</span><span class="n">hmac_key</span><span class="p">,</span> <span class="n">message</span><span class="p">)</span>
    <span class="n">data16</span> <span class="o">=</span> <span class="n">digest20</span><span class="p">[:</span><span class="mi">16</span><span class="p">]</span>

    <span class="c1"># 4. Recover or load the white-box table.
</span>    <span class="k">if</span> <span class="n">apk_bytes</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">table</span> <span class="o">=</span> <span class="n">recover_wb_table</span><span class="p">(</span><span class="n">apk_bytes</span><span class="p">)</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">table</span> <span class="o">=</span> <span class="n">profile</span><span class="p">.</span><span class="n">wb_table</span>

    <span class="c1"># 5. White-box stage.
</span>    <span class="n">a16</span> <span class="o">=</span> <span class="n">white_box_transform</span><span class="p">(</span><span class="n">data16</span><span class="p">,</span> <span class="n">table</span><span class="p">,</span> <span class="n">profile</span><span class="p">)</span>

    <span class="c1"># 6. a2 core.
</span>    <span class="n">mid16</span> <span class="o">=</span> <span class="nb">bytes</span><span class="p">(</span>
        <span class="n">profile</span><span class="p">.</span><span class="n">mask16</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>
        <span class="o">^</span> <span class="n">profile</span><span class="p">.</span><span class="n">b16</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>
        <span class="o">^</span> <span class="p">((</span><span class="n">data16</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">+</span> <span class="n">a16</span><span class="p">[</span><span class="n">i</span><span class="p">])</span> <span class="o">&amp;</span> <span class="mh">0xFF</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">16</span><span class="p">)</span>
    <span class="p">)</span>

    <span class="c1"># 7. Finalize and format.
</span>    <span class="n">raw16</span> <span class="o">=</span> <span class="n">finalize</span><span class="p">(</span><span class="n">mid16</span><span class="p">,</span> <span class="n">profile</span><span class="p">.</span><span class="n">mask16</span><span class="p">,</span> <span class="n">profile</span><span class="p">.</span><span class="n">final_fixed_byte</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">raw16</span><span class="p">.</span><span class="nb">hex</span><span class="p">()</span>
</code></pre></div></div>

<h2 id="12-验证要求">12. 验证要求</h2>

<p>实现至少应执行以下检查：</p>

<ol>
  <li><code class="language-plaintext highlighter-rouge">a1</code> 的 key-loop 输入长度为 36 字节。</li>
  <li>HMAC 输出长度为 20 字节。</li>
  <li><code class="language-plaintext highlighter-rouge">data16 == digest20[:16]</code>。</li>
  <li>APK 外层载荷长度为 <code class="language-plaintext highlighter-rouge">0x2927A</code>。</li>
  <li><code class="language-plaintext highlighter-rouge">.XBT</code> magic 为 <code class="language-plaintext highlighter-rouge">.XBT</code>，version 为 1。</li>
  <li><code class="language-plaintext highlighter-rouge">.XBT</code> 内层压缩长度为 <code class="language-plaintext highlighter-rouge">0x2925E</code>。</li>
  <li>内层解压结果和最终白盒表长度均为 <code class="language-plaintext highlighter-rouge">0x2E000</code>。</li>
  <li><code class="language-plaintext highlighter-rouge">data16</code>、<code class="language-plaintext highlighter-rouge">A16</code>、<code class="language-plaintext highlighter-rouge">B16_PROFILE</code>、<code class="language-plaintext highlighter-rouge">MASK16_PROFILE</code>、<code class="language-plaintext highlighter-rouge">mid16</code> 和 <code class="language-plaintext highlighter-rouge">raw16</code> 均为 16 字节。</li>
  <li>最终字符串长度为 32，并且只包含小写十六进制字符。</li>
  <li>使用同一 binary profile 时，message、key、digest、A16、mid16 和最终 hex 应逐阶段
与对应 trace 一致。</li>
</ol>

<h2 id="13-实现边界">13. 实现边界</h2>

<p>本文已经完整描述 a2 的外部可观察计算：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>request fields
    -&gt; message and HMAC key
    -&gt; HMAC-SHA1 20 bytes
    -&gt; first 16 bytes
    -&gt; white-box A16
    -&gt; a2 core
    -&gt; finalize
    -&gt; lowercase hex
</code></pre></div></div>

<p>VM 内部的 continuation 状态、ValueSlot C++ 类型名和 native target 业务命名不属于输出
算法本身。它们可以用于解释 profile 常量如何初始化，但不应被误写成新的摘要算法，或
作为 a2 行为级复现的必要步骤。</p>]]></content><author><name></name></author><summary type="html"><![CDATA[1. 文档范围]]></summary></entry><entry><title type="html">从运行时证据恢复多层字符串生成链</title><link href="https://androidreverser-test.github.io/2026/09/13/trace-ret-publication.html" rel="alternate" type="text/html" title="从运行时证据恢复多层字符串生成链" /><published>2026-09-13T00:00:00+00:00</published><updated>2026-09-13T00:00:00+00:00</updated><id>https://androidreverser-test.github.io/2026/09/13/trace-ret-publication</id><content type="html" xml:base="https://androidreverser-test.github.io/2026/09/13/trace-ret-publication.html"><![CDATA[<p><img src="/ret.png" alt="复现结果" /></p>

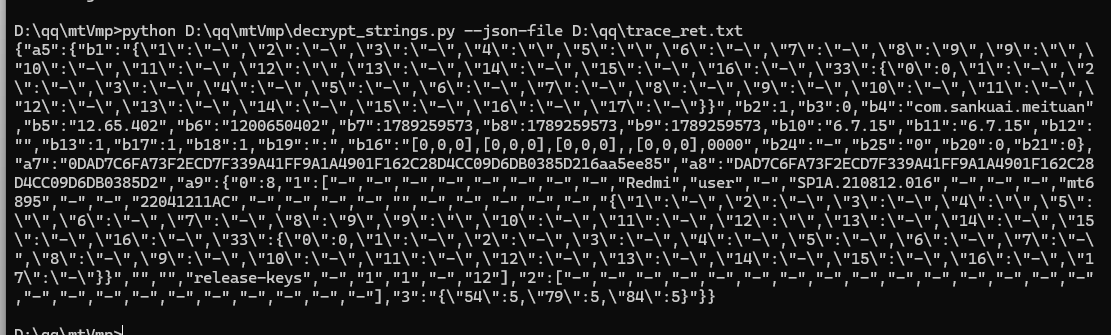
<blockquote>
  <p>图：脱敏前的复现结果截图。本文正文不公开截图中未必要的业务字段、样本 token、密钥材料或实现脚本。</p>
</blockquote>

<h2 id="摘要">摘要</h2>

<p>在移动端二进制分析中，最终看到的字符串往往不是静态常量，而是经过对象组装、压缩、定制流变换、标准分组密码和编码层层生成的结果。只看最后一层 Base64，通常无法判断输入来源，也无法区分真正的密码算法和业务层封装。</p>

<p>本文记录一次基于运行时 trace 与静态反汇编的脱敏分析过程。目标不是公布某个产品的密钥或实现细节，而是展示如何从最终字符串反向恢复数据流，并准确描述以下几类生成链：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">a5</code>：JSON、zlib、定制状态表流变换和 Base64。</li>
  <li><code class="language-plaintext highlighter-rouge">a7</code>：带业务封装的 AES-128-CBC 和 Base64。</li>
  <li><code class="language-plaintext highlighter-rouge">a8</code>：CRC-32、十六进制解码、固定 XOR 派生和大写十六进制编码。</li>
  <li><code class="language-plaintext highlighter-rouge">a9</code>：JSON、zlib、CRC-32 前缀、PKCS#7、Twofish-128-CBC 和 Base64。</li>
  <li><code class="language-plaintext highlighter-rouge">a2</code>：尚未被证明为标准摘要算法的 16 字节 tagged-value 数据流及小写十六进制序列化。</li>
</ul>

<p>文章还给出一套可重复的工作流程：先定位最终写入，再沿缓冲区和长度向前追踪，最后用静态代码确认循环和用独立实现验证边界。所有真实函数偏移、内存地址、密钥、IV、mask、样本字符串和可执行脚本均已移除或符号化。</p>

<h2 id="公开范围与脱敏规则">公开范围与脱敏规则</h2>

<p>本文只保留适合公开讨论的算法结构和证据方法：</p>

<ul>
  <li>函数以“JSON 序列化器”“状态表初始化器”“Base64 编码器”等职责称呼，不公开真实函数名、偏移或地址。</li>
  <li>真实密钥、IV、XOR mask、UUID、时间值、完整输入输出 token 均使用符号表示。</li>
  <li>只保留能够说明算法的长度关系和边界条件，不复制可直接用于解密的样本。</li>
  <li>不给出 Python、Shell 或其他语言的解密脚本；文中的公式只用于说明算法，不构成可直接运行的实现。</li>
  <li>未被 trace 或静态代码直接证明的内容，标记为“未确认”，不根据字段名称猜测其业务语义。</li>
</ul>

<h2 id="1-分析对象">1. 分析对象</h2>

<p>目标记录是一个包含多个字符串字段的 JSON 对象。字段名在本文中保留为匿名标签，便于描述数据流，但字段的产品语义不作判断。</p>

<p>其中，<code class="language-plaintext highlighter-rouge">a5</code>、<code class="language-plaintext highlighter-rouge">a7</code>、<code class="language-plaintext highlighter-rouge">a8</code> 和 <code class="language-plaintext highlighter-rouge">a9</code> 都能从运行时证据中恢复出明确的生成或逆向路径；<code class="language-plaintext highlighter-rouge">a2</code> 只能闭合到一段 16 字节结果的格式化层，不能据此命名为 MD5、SHA、AES、Twofish 或其他标准摘要。</p>

<p>从结构上看，这不是一条统一的“加密算法”，而是多条相互关联但用途不同的编码链：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>记录字段
├── a5: 结构化 JSON -&gt; zlib -&gt; 定制状态表流变换 -&gt; Base64
├── a7: a8 与时间封装 -&gt; PKCS#7 -&gt; AES-128-CBC -&gt; Base64
├── a8: 动态组件 -&gt; CRC-32 -&gt; hex -&gt; 固定 XOR -&gt; 大写 hex
├── a9: 结构化 JSON -&gt; zlib -&gt; CRC-32 前缀 -&gt; PKCS#7
│       -&gt; Twofish-128-CBC -&gt; Base64
└── a2: tagged-value 字节流 -&gt; 16 字节结果 -&gt; 小写 hex（实锤vm层算法，待解决）
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">a7</code> 依赖 <code class="language-plaintext highlighter-rouge">a8</code> 的文本，因此字段之间存在生产顺序；<code class="language-plaintext highlighter-rouge">a5</code> 和 <code class="language-plaintext highlighter-rouge">a9</code> 分别使用自己的输入对象和密码路径，不能因为最终形式都是 Base64 就把它们视为同一算法。</p>

<h2 id="2-证据来源与工具">2. 证据来源与工具</h2>

<p>分析使用两类互相校验的证据：</p>

<ol>
  <li><strong>运行时证据</strong>：函数调用参数、输入输出指针、缓冲区长度、内存读写、字符串对象更新和返回值。</li>
  <li><strong>静态证据</strong>：反汇编和反编译得到的循环、分支、查表、字节序、轮函数和调用关系。</li>
</ol>

<p>大体积 trace 不适合用普通文本编辑器或一次性读取。本文使用的 <code class="language-plaintext highlighter-rouge">trace-search</code> 已开源，项目地址为：</p>

<p><a href="https://github.com/AndroidReverser-Test/trace_search">https://github.com/AndroidReverser-Test/trace_search</a></p>

<p>它适合对超大日志建立索引后执行精确字符串搜索、分段扫描、上下文读取和结果导出。工具本身不负责判断算法，算法判断仍需要把动态记录与静态代码逐项对应。</p>

<h2 id="3-总体工作流程">3. 总体工作流程</h2>

<h3 id="31-建立可搜索的运行时快照">3.1 建立可搜索的运行时快照</h3>

<p>先将原始 trace 交给索引工具，并等待索引状态变为可查询。对目标字符串执行大小写敏感的 literal 搜索，记录命中数量、最终字符串长度以及相邻的对象更新记录。</p>

<p>这一步的目标不是马上识别算法，而是找到一个可靠的终点：</p>

<ul>
  <li>最终字符串在哪里被写入。</li>
  <li>写入长度是多少。</li>
  <li>写入前的源缓冲区是什么。</li>
  <li>哪个调用负责把源缓冲区包装成最终字符串。</li>
</ul>

<p>如果日志服务有单次扫描上限，应按行区间分段搜索，并合并结果。搜索策略、分段范围和命中数属于证据链的一部分，应记录在分析笔记中。</p>

<h3 id="32-从最终写入点向前追踪">3.2 从最终写入点向前追踪</h3>

<p>找到最终写入后，沿以下字段逐层回溯：</p>

<table>
  <thead>
    <tr>
      <th>记录项</th>
      <th>作用</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>缓冲区标识</td>
      <td>判断前后是否是同一对象或搬迁后的对象</td>
    </tr>
    <tr>
      <td>长度</td>
      <td>确认编码、填充和压缩边界</td>
    </tr>
    <tr>
      <td>输入输出关系</td>
      <td>区分原地变换、复制、追加和重新分配</td>
    </tr>
    <tr>
      <td>调用参数</td>
      <td>判断压缩、加密和编码的模式</td>
    </tr>
    <tr>
      <td>首块或首字节</td>
      <td>用于验证状态初始化和字节序</td>
    </tr>
  </tbody>
</table>

<p>每确认一层，就把“当前输出”变成“上一层输入”，继续向前。不要跳过中间的 <code class="language-plaintext highlighter-rouge">realloc</code>、字符串追加或临时缓冲区，否则很容易把同一个地址在不同生命周期中的内容混为一谈。</p>

<h3 id="33-用静态代码确认循环">3.3 用静态代码确认循环</h3>

<p>运行时 trace 常能告诉我们“读了什么、写了什么”，但不一定能给出完整循环。静态分析用于确认：</p>

<ul>
  <li>状态表的初始化顺序。</li>
  <li>索引是否按字节取模。</li>
  <li>查表前是否发生交换。</li>
  <li>密码轮数、key schedule 和 whitening 的布局。</li>
  <li>CRC 的初始值、更新方向和最终取反。</li>
  <li>CBC 的 chaining block 何时更新。</li>
</ul>

<p>静态代码不能单独证明某个常量在本次运行中确实被使用。因此每个算法结论都应同时绑定到动态参数、代表性内存访问或首块结果。</p>

<h3 id="34-将结果写成可验证的中间边界">3.4 将结果写成可验证的中间边界</h3>

<p>不要只记录“解密成功”。应至少记录以下边界：</p>

<ul>
  <li>Base64 解码后的字节长度。</li>
  <li>压缩流的首部和长度。</li>
  <li>PKCS#7 的填充值和总长度。</li>
  <li>CBC 第一个分组的输入、输出或 chaining 行为。</li>
  <li>CRC 的输入范围，而不是只记录 CRC 值。</li>
  <li>解压后的 JSON 长度和语法是否成立。</li>
</ul>

<p>这些边界可以在不公开密钥和样本 token 的情况下证明算法路径是否一致。</p>

<h3 id="35-区分直接证据与逆向复现">3.5 区分直接证据与逆向复现</h3>

<p>本文使用三个证据等级：</p>

<ul>
  <li><strong>直接记录</strong>：trace 明确打印了参数、长度、读写或返回值。</li>
  <li><strong>静态确认</strong>：反汇编明确显示了对应循环或变换。</li>
  <li><strong>确定性复现</strong>：使用前两类信息逆向执行后得到与下一层长度、格式或边界一致的结果。</li>
</ul>

<p>如果某个字段只在最终 JSON 中出现，但没有找到它的生产者，不能把字段名解释成设备 ID、时间戳或摘要。应保留为匿名组件，并明确上游仍未确认。</p>

<h2 id="4-a5jsonzlib-与定制状态表流变换">4. <code class="language-plaintext highlighter-rouge">a5</code>：JSON、zlib 与定制状态表流变换</h2>

<h3 id="41-生成链">4.1 生成链</h3>

<p><code class="language-plaintext highlighter-rouge">a5</code> 的完整结构为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>JSON 字节串
    -&gt; zlib deflate
压缩字节串
    -&gt; 定制 KSA 与状态表 XOR
变换后的字节串
    -&gt; 标准 Base64
a5 文本
</code></pre></div></div>

<p>参考样本中，JSON、压缩流和最终 Base64 的长度分别处于“数百字节”量级；具体长度取决于对象字段和运行时数据。长度关系本身应作为验证条件保存，但不需要公开真实样本。</p>

<h3 id="42-动态-key-source">4.2 动态 key source</h3>

<p>key 不是一个可以从固定样本复制的常量，而是在调用前由三个运行时字段拼接得到：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>source = field_1 || decimal(field_2) || decimal(field_3)
</code></pre></div></div>

<p>在已观察的 profile 中：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">field_1</code> 是固定长度的文本组件。</li>
  <li><code class="language-plaintext highlighter-rouge">field_2</code> 和 <code class="language-plaintext highlighter-rouge">field_3</code> 先转成 ASCII 十进制，不带分隔符。</li>
  <li>拼接后的 source 长度为 48 字节。</li>
</ul>

<p>这一步很重要。若把某一次运行中的时间或数值写死，脚本只能解开同一条样本，不能处理另一个记录。正确的复现器必须从当前记录重新生成 source。</p>

<h3 id="43-派生-key">4.3 派生 key</h3>

<p>source 经过一个周期为 16 字节的固定 XOR mask 变换，得到 48 字节工作 key：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>K[i] = source[i] XOR M[i mod 16]
</code></pre></div></div>

<p>其中 <code class="language-plaintext highlighter-rouge">M</code> 是应用内的静态 16 字节材料。本文不公开 <code class="language-plaintext highlighter-rouge">M</code> 或任何由它产生的工作 key，只保留索引关系、周期和长度。</p>

<h3 id="44-状态初始化与-ksa">4.4 状态初始化与 KSA</h3>

<p>状态区包含一个 256 字节置换表，以及用于保存两个索引的状态字节。初始化时：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>S[0] = 0, S[1] = 1, ..., S[255] = 255
j = 0
</code></pre></div></div>

<p>随后执行 256 轮 KSA。每轮的精确定义为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>t = S[i]
j = (j + i + t + K[i mod 48]) mod 256
swap(S[i], S[j])
</code></pre></div></div>

<p>这里的 <code class="language-plaintext highlighter-rouge">+ i</code> 是该实现区别于标准 RC4 KSA 的关键。虽然数据阶段采用了类似 RC4 的置换表流生成方式，但不能直接把它命名为标准 RC4；它使用了不同的 key schedule 输入和不同的 KSA 累加项。</p>

<h3 id="45-字节流变换">4.5 字节流变换</h3>

<p>KSA 完成后，数据阶段从 <code class="language-plaintext highlighter-rouge">i = 0, j = 0</code> 开始。每个输入字节执行：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>i = (i + 1) mod 256
j = (j + S[i]) mod 256
swap(S[i], S[j])
q = S[(S[i] + S[j]) mod 256]
output[n] = input[n] XOR q
</code></pre></div></div>

<p>输入和输出在本次调用中使用同一缓冲区，因此它是原地变换。由于状态由 key 和固定初始状态唯一决定，解码时重新建立同一状态并再次执行 XOR 即可恢复压缩流；XOR 本身是自逆的。</p>

<h3 id="46-base64-与逆向顺序">4.6 Base64 与逆向顺序</h3>

<p>数据变换完成后使用标准 Base64：每三个输入字节拆成四个 6-bit 索引，使用标准 64 字符表输出。由于参考压缩长度刚好落在三字节边界上，最终没有额外的 <code class="language-plaintext highlighter-rouge">=</code> 填充字符。</p>

<p>逆向顺序为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Base64 解码
    -&gt; 重新执行相同状态表 XOR
    -&gt; zlib 解压
    -&gt; JSON 解析
</code></pre></div></div>

<p>主要验证条件是：Base64 解码后的长度符合压缩输出长度、变换结果具有合法 zlib 首部、解压后长度与 JSON 语法均成立。</p>

<h2 id="5-a7业务封装与-aes-128-cbc">5. <code class="language-plaintext highlighter-rouge">a7</code>：业务封装与 AES-128-CBC</h2>

<h3 id="51-明文封装">5.1 明文封装</h3>

<p><code class="language-plaintext highlighter-rouge">a7</code> 的 AES 明文不是单独的随机字段，而是由 <code class="language-plaintext highlighter-rouge">a8</code> 和时间字段拼接得到：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>plain = ASCII("0")
        || a8
        || ASCII("1")
        || lowercase_hex(epoch_seconds, width=8)
</code></pre></div></div>

<p>其中时间先取秒级整数，再格式化为 8 个小写十六进制字符。两个单字节标记用于界定前后的字段。该封装的长度、标记位置和时间格式都可以通过字符串对象的追加顺序与最终长度确认。</p>

<h3 id="52-pkcs7">5.2 PKCS#7</h3>

<p>AES 的分组长度为 16 字节。设明文长度为 <code class="language-plaintext highlighter-rouge">L</code>，填充长度为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>p = 16 - (L mod 16)
</code></pre></div></div>

<p>随后追加 <code class="language-plaintext highlighter-rouge">p</code> 个值为 <code class="language-plaintext highlighter-rouge">p</code> 的字节。参考样本的明文不是 16 的整数倍，因此末尾填充字节数量大于零；具体明文和填充值不在本文公开。</p>

<h3 id="53-aes-128-cbc">5.3 AES-128-CBC</h3>

<p>静态代码显示 key schedule 选择 128-bit 密钥，即 AES-128 的 10 轮结构。实现使用查表优化，但算法语义仍是标准 AES：</p>

<ul>
  <li>字节状态按 AES 规定排列。</li>
  <li>每轮包含 SubBytes、ShiftRows、MixColumns 和 AddRoundKey；最后一轮不执行 MixColumns。</li>
  <li>逆向时使用逆 ShiftRows、逆 SubBytes、逆 MixColumns 和逆轮密钥。</li>
</ul>

<p>CBC 加密公式为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>C[0] = AES_K(P[0] XOR IV)
C[n] = AES_K(P[n] XOR C[n-1])
</code></pre></div></div>

<p>解密公式为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>P[0] = AES_K^-1(C[0]) XOR IV
P[n] = AES_K^-1(C[n]) XOR C[n-1]
</code></pre></div></div>

<p>本文不公开应用内的 128-bit key 和 16-byte IV。复现时只需要确认它们是同一 profile 的静态参数，并验证 CBC chaining block 在每个分组后更新为当前 ciphertext block。</p>

<h3 id="54-base64-与验证">5.4 Base64 与验证</h3>

<p>PKCS#7 填充后的 ciphertext 经过标准 Base64 得到 <code class="language-plaintext highlighter-rouge">a7</code>。解码验证顺序如下：</p>

<ol>
  <li>Base64 严格解码，确认长度是 16 字节整数倍。</li>
  <li>按 AES-128-CBC 解密。</li>
  <li>检查 PKCS#7 的最后一个字节和整段填充。</li>
  <li>检查明文首尾标记、<code class="language-plaintext highlighter-rouge">a8</code> 长度和时间字段格式。</li>
</ol>

<p>因此，即使不公开 key 和 IV，也能准确描述并验证整个算法边界。</p>

<h2 id="6-a8crc-32hex-解码与固定-xor-派生">6. <code class="language-plaintext highlighter-rouge">a8</code>：CRC-32、hex 解码与固定 XOR 派生</h2>

<h3 id="61-生成链">6.1 生成链</h3>

<p><code class="language-plaintext highlighter-rouge">a8</code> 不是简单的固定前缀字符串。完整链为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>两个动态文本组件
    -&gt; 固定格式拼接
48 字节 ASCII preimage
    -&gt; CRC-32/ISO-HDLC
8 个小写十六进制校验字符
    -&gt; 拼接
56 个小写十六进制字符
    -&gt; hex decode
28 个原始字节
    -&gt; 固定 28 字节 XOR mask
28 个派生字节
    -&gt; 大写 hex
56 字节 a8
</code></pre></div></div>

<h3 id="62-crc-32-输入格式">6.2 CRC-32 输入格式</h3>

<p>设两个动态组件分别为长度 32 和 11 的 ASCII 文本，则 preimage 的结构为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>preimage = ASCII("0000")
           || component_32
           || component_11
           || ASCII("0")
</code></pre></div></div>

<p>总长度为 48 字节。两个组件的真实内容和业务语义未公开；trace 只证明它们被以这两个长度复制到输入缓冲区。</p>

<p>该 CRC 是 reflected CRC-32/ISO-HDLC，状态更新为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>state = 0xffffffff
for each byte b:
    state = table[(state XOR b) AND 0xff] XOR (state &gt;&gt; 8)
crc = bitwise_not(state) AND 0xffffffff
</code></pre></div></div>

<p>最终 checksum 使用 8 位小写十六进制格式化，并追加到 preimage 后面，形成 56 字节的 source 文本。</p>

<h3 id="63-hex-decodexor-和输出">6.3 hex decode、XOR 和输出</h3>

<p>source 文本每两个十六进制字符组成一个字节，因此 56 个字符被解码为 28 字节。随后与静态 28 字节 mask 逐字节 XOR：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>derived[i] = decoded[i] XOR mask[i], 0 &lt;= i &lt; 28
</code></pre></div></div>

<p>最后使用大写十六进制字母表把 28 个字节重新编码为 56 字符文本。</p>

<p>调用方对结果的前缀进行比较属于生成后的校验或业务筛选，不是上述派生链的一部分。分析时必须把“生成值”和“生成后检查”分开，否则容易误以为前缀本身参与了 key derivation。</p>

<h3 id="64-复现边界">6.4 复现边界</h3>

<p>从两个动态组件到 <code class="language-plaintext highlighter-rouge">a8</code> 的每一步都能独立复现：拼接长度、CRC 输入范围、checksum 格式、hex 解码长度、XOR 长度和最终大写编码均有明确边界。</p>

<p>两个动态组件更早的 Java/native 生产者没有在当前 trace 中闭合，因此不能在文章中把它们命名为设备 ID、安装标识、时间戳或摘要。</p>

<h2 id="7-a9jsonzlibcrc-32twofish-cbc-与-base64">7. <code class="language-plaintext highlighter-rouge">a9</code>：JSON、zlib、CRC-32、Twofish-CBC 与 Base64</h2>

<h3 id="71-json-序列化">7.1 JSON 序列化</h3>

<p><code class="language-plaintext highlighter-rouge">a9</code> 的输入是一个运行时对象图，而不是预先存在的字符串。序列化器递归处理对象、数组、键、冒号、逗号、字符串和值，生成紧凑 JSON 字节串。</p>

<p>参考 trace 中，序列化后的 JSON 处于约 774 字节的 profile，随后进入 zlib。对象节点的业务来源没有全部继续向上追踪，本文只描述序列化和加密边界。</p>

<h3 id="72-zlib-与-crc-32-前缀">7.2 zlib 与 CRC-32 前缀</h3>

<p>JSON 使用 zlib deflate，压缩级别采用库默认路径并以完成模式结束。参考 profile 中，JSON 压缩为 216 字节 zlib stream。</p>

<p>CRC-32 计算范围非常关键：它覆盖的是<strong>未填充的 zlib stream</strong>，不是 JSON、PKCS#7 后的数据，也不是最终 ciphertext。设压缩流为 <code class="language-plaintext highlighter-rouge">Z</code>，则：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>prefix = lowercase_hex(CRC32_ISO_HDLC(Z), width=8)
</code></pre></div></div>

<p>这个 8 字符前缀位于最终字段最外层，后面才是 Base64 body。它的作用是让解码器在解压前验证压缩流是否完整。</p>

<h3 id="73-pkcs7">7.3 PKCS#7</h3>

<p>Twofish 的分组长度同样为 16 字节。将 zlib stream 按 PKCS#7 补齐到 16 的整数倍：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>p = 16 - (len(Z) mod 16)
padded = Z || p repeated bytes whose value is p
</code></pre></div></div>

<p>参考 profile 中，216 字节流增加 8 个填充字节，得到 224 字节的 CBC 输入。必须先去除填充，再对剩余的 zlib stream 做 CRC 校验。</p>

<h3 id="74-twofish-128-参数与轮结构">7.4 Twofish-128 参数与轮结构</h3>

<p>静态代码和动态 context 写入共同确认该分组变换为标准 Twofish-128 的优化实现，而不是自定义的“类似 Twofish”算法。其结构包括：</p>

<ul>
  <li>128-bit key。</li>
  <li>16 轮数据变换。</li>
  <li>40 个 32-bit round subkeys，包括输入和输出 whitening 使用的子密钥。</li>
  <li>4 张由 key 派生的 256 项 keyed S-box。</li>
  <li>RS 编码生成 S-box key，q permutation 和 MDS 矩阵参与 <code class="language-plaintext highlighter-rouge">h()</code> 函数。</li>
  <li>以小端序加载 32-bit word，并使用 T-table 加速 keyed S-box 与 MDS 组合。</li>
</ul>

<p>Twofish key schedule 的关键步骤是：</p>

<ol>
  <li>将 128-bit key 拆分为偶数和奇数 32-bit/64-bit 片段。</li>
  <li>使用 Reed-Solomon 矩阵从 key material 生成 S-box key。</li>
  <li>通过 q permutation、key-dependent byte XOR 和 MDS 组合生成四张 keyed S-box。</li>
  <li>对交错输入生成 40 个 round words，并按标准旋转规则排列。</li>
</ol>

<p>数据分组使用 Twofish 标准的输入 whitening、16 轮 Feistel-like 变换和输出 whitening。每轮使用两个 <code class="language-plaintext highlighter-rouge">g()</code> 结果：一个来自四张 S-box 按低到高字节取表，另一个按相反字节顺序取表，再经过加法、旋转和轮密钥组合。T-table 只是把这些查表和 MDS 操作预计算，不能改变 Twofish 的数学结构。</p>

<h3 id="75-cbc-模式">7.5 CBC 模式</h3>

<p>设 padded stream 分组为 <code class="language-plaintext highlighter-rouge">P[0]...P[n]</code>，应用内固定 IV 记为 <code class="language-plaintext highlighter-rouge">IV</code>：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>C[0] = Twofish_K(P[0] XOR IV)
C[n] = Twofish_K(P[n] XOR C[n-1])
</code></pre></div></div>

<p>每次分组输出后，当前 ciphertext block 被复制到 chaining 状态，作为下一块的 XOR 输入。参考 profile 共有 14 个 16-byte block，数量由 224 字节 CBC 输入决定，而不是由 JSON 字段数量决定。</p>

<p>本文不公开 Twofish key、IV、S-box 表或 round subkeys。公开这些值没有必要，因为算法类型、key schedule、CBC 边界和校验顺序已经足以描述实现。</p>

<h3 id="76-外层拼接与逆向顺序">7.6 外层拼接与逆向顺序</h3>

<p>最终 <code class="language-plaintext highlighter-rouge">a9</code> 结构为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>a9 = prefix || Base64(ciphertext)
</code></pre></div></div>

<p>其中 <code class="language-plaintext highlighter-rouge">prefix</code> 是未填充 zlib stream 的 8 字符小写 CRC-32，Base64 body 对应 PKCS#7 后的 Twofish-CBC ciphertext。</p>

<p>逆向流程为：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>拆出 8 字符 CRC 前缀和 Base64 body
    -&gt; Base64 解码
    -&gt; Twofish-128-CBC 解密
    -&gt; 检查并移除 PKCS#7
    -&gt; 对 zlib stream 计算 CRC-32 并比较前缀
    -&gt; zlib 解压
    -&gt; JSON 解析
</code></pre></div></div>

<p>长度关系是很强的验证信号：224 字节 ciphertext 应编码为 300 字节 Base64 body，外层再加 8 字符前缀。任何不满足 block 对齐或长度关系的输入，都不应强行套用该 profile。</p>

<h2 id="8-a2已确认的格式化层与未闭合的数据流">8. <code class="language-plaintext highlighter-rouge">a2</code>：已确认的格式化层与未闭合的数据流</h2>

<p><code class="language-plaintext highlighter-rouge">a2</code> 的最终层是一个 16 字节原始块到 32 字符小写十六进制文本的序列化：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>raw16[0..15]
    -&gt; 每个字节格式化为两个小写 hex 字符
    -&gt; 32 字符 a2
</code></pre></div></div>

<p>trace 还显示，<code class="language-plaintext highlighter-rouge">raw16</code> 由一个更早的 20-byte opaque input 经 tagged-value getter、字节读取、XOR 和分散的 byte store 得到。部分字节的输入位置、XOR 操作和目标位置已经可以逐项对应，但完整 flattened control-flow 的高层语义尚未闭合。</p>

<p>因此目前只能确认：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">raw16</code> 是一段 16 字节数据。</li>
  <li>最终编码是 <code class="language-plaintext highlighter-rouge">%02x</code> 语义的小写十六进制。</li>
  <li>上游包含 tagged-value 的字节级 XOR 和覆盖写入。</li>
  <li>没有足够证据把它命名为任何标准 hash 或密码算法。</li>
</ul>

<p>这是逆向分析中重要的边界：格式化层已知，不代表生成层就是哈希。</p>

<h2 id="9-版本差异与-profile-识别">9. 版本差异与 profile 识别</h2>

<p>同一字段名不一定永远使用同一个格式。后续样本中可能出现：</p>

<ul>
  <li>带版本标记的 KMS envelope，而不是已确认的 AES-CBC 外壳。</li>
  <li>Base64 解码后长度不同，无法满足旧 Twofish profile 的 16-byte 分组边界。</li>
  <li><code class="language-plaintext highlighter-rouge">a8</code> 仍是 56 字符 hex，但动态组件或大小写形式发生变化。</li>
  <li><code class="language-plaintext highlighter-rouge">a5</code> 的 key source 随当前记录变化，不能复用前一次运行的 source。</li>
</ul>

<p>因此解码器应先识别 profile，再执行算法：</p>

<ol>
  <li>检查字段的外层版本标记和字符集。</li>
  <li>检查 Base64、hex、block size 和长度关系。</li>
  <li>只有全部前置条件满足时才进入 AES 或 Twofish 路径。</li>
  <li>对未知 profile 输出“不支持该格式”的诊断，而不是使用旧 key 和旧算法强行解密。</li>
</ol>

<p>这种策略比“遇到失败就换一个 key”更可靠，也能避免把格式升级误判为密钥错误。</p>

<h2 id="10-复现与验证策略">10. 复现与验证策略</h2>

<p>公开文章不需要附带脚本，也可以通过以下检查验证实现是否准确。</p>

<h3 id="101-a5-验证">10.1 <code class="language-plaintext highlighter-rouge">a5</code> 验证</h3>

<ul>
  <li>当前记录重新拼接 key source，不能使用固定时间值。</li>
  <li>source 长度必须符合 profile，派生 key 的 mask 索引按 16 字节循环。</li>
  <li>KSA 每轮必须包含 <code class="language-plaintext highlighter-rouge">i</code>、当前 <code class="language-plaintext highlighter-rouge">S[i]</code>、key 字节和交换操作。</li>
  <li>状态流变换首字节应同时满足 zlib 首部、XOR 关系和写回位置。</li>
  <li>Base64 解码、状态逆变换和 zlib 解压后必须得到合法 JSON。</li>
</ul>

<h3 id="102-a7-验证">10.2 <code class="language-plaintext highlighter-rouge">a7</code> 验证</h3>

<ul>
  <li>明文中 <code class="language-plaintext highlighter-rouge">a8</code> 的位置和长度正确。</li>
  <li>时间字段是固定宽度的小写十六进制秒值。</li>
  <li>PKCS#7 填充后的长度是 16 的整数倍。</li>
  <li>AES-128 的 10 轮 key schedule 和 CBC chaining block 顺序正确。</li>
  <li>去除填充后，首尾标记、<code class="language-plaintext highlighter-rouge">a8</code> 和时间字段均能解析。</li>
</ul>

<h3 id="103-a8-验证">10.3 <code class="language-plaintext highlighter-rouge">a8</code> 验证</h3>

<ul>
  <li>CRC 输入必须是 48 字节 preimage，而不是包含 checksum 的完整 source。</li>
  <li>CRC 使用 reflected ISO-HDLC 参数，最终取反并按 8 位小写 hex 格式化。</li>
  <li>56 字符 source 必须先 hex decode 为 28 字节。</li>
  <li>XOR mask 长度必须是 28 字节，最终输出必须重新编码为大写 hex。</li>
</ul>

<h3 id="104-a9-验证">10.4 <code class="language-plaintext highlighter-rouge">a9</code> 验证</h3>

<ul>
  <li>CRC 输入是未填充 zlib stream。</li>
  <li>PKCS#7 在 Twofish-CBC 之前添加，在 CRC 比较前移除。</li>
  <li>Twofish 使用 128-bit key、16 轮、key-dependent S-box 和 whitening。</li>
  <li>CBC 初始块使用 IV，后续使用前一块 ciphertext。</li>
  <li>外层 8 字符前缀与解密后的 zlib stream CRC 一致。</li>
  <li>zlib 解压结果是合法 JSON，而不是任意可打印字符串。</li>
</ul>

<h3 id="105-正向与逆向交叉验证">10.5 正向与逆向交叉验证</h3>

<p>最可靠的验证不是只做一次解密，而是双向检查：</p>

<ol>
  <li>从最终字段逆向得到中间 JSON 或封装明文。</li>
  <li>对中间结果按相同顺序正向生成。</li>
  <li>只比较长度、格式、校验和以及内部测试样本的最终字节，不在公开文档中公布实际 token。</li>
  <li>对改变了动态组件的记录重新生成 <code class="language-plaintext highlighter-rouge">a5</code> source，确认没有依赖旧样本缓存。</li>
</ol>

<h2 id="11-尚未确认的边界">11. 尚未确认的边界</h2>

<p>以下内容在当前证据范围内仍不应下结论：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">a5</code> source 中文本组件和两个数值字段的最初业务生产 API。</li>
  <li><code class="language-plaintext highlighter-rouge">a5</code> 的 16-byte mask 更早来自哪里。</li>
  <li><code class="language-plaintext highlighter-rouge">a7</code> 所依赖的 <code class="language-plaintext highlighter-rouge">a8</code> 动态组件在 Java/native 层的业务语义。</li>
  <li><code class="language-plaintext highlighter-rouge">a8</code> 两个组件是否分别代表设备、安装、环境或其他属性。</li>
  <li><code class="language-plaintext highlighter-rouge">a9</code> JSON 各节点对应的独立上游 API。</li>
  <li><code class="language-plaintext highlighter-rouge">a2</code> 的 20-byte opaque input 生产者和完整 tagged-value 派生程序。</li>
  <li>保护层中所有间接控制流是否构成完整通用虚拟机。</li>
</ul>

<p>这些问题需要更多运行时样本、上游调用链或业务接口证据。仅凭字段名、固定字符串或一段混淆后的 XOR，不足以给出可靠命名。</p>

<h2 id="12-结论">12. 结论</h2>

<p>本次分析的核心成果不是得到几个可复制的字符串，而是闭合了从对象构造到最终文本的多个可验证边界：</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">a5</code> 是 JSON 经 zlib 后进入一个带非标准 KSA 项的状态表 XOR 流变换，再做 Base64。</li>
  <li><code class="language-plaintext highlighter-rouge">a7</code> 是由 <code class="language-plaintext highlighter-rouge">a8</code> 和时间字段构成的业务明文，经 PKCS#7、AES-128-CBC 和 Base64 封装。</li>
  <li><code class="language-plaintext highlighter-rouge">a8</code> 是 48 字节文本的 CRC-32 校验、hex 解码、28 字节固定 XOR 和大写 hex 派生。</li>
  <li><code class="language-plaintext highlighter-rouge">a9</code> 是 JSON、zlib、压缩流 CRC-32 前缀、PKCS#7、标准 Twofish-128-CBC 和 Base64 的组合。</li>
  <li><code class="language-plaintext highlighter-rouge">a2</code> 目前只闭合到 16 字节结果的小写 hex 序列化，不能被误命名为标准摘要。</li>
</ul>

<p>在实际逆向中，最有效的原则是“先证据，后命名”：先用 <code class="language-plaintext highlighter-rouge">trace-search</code> 定位终点和缓冲区，再用静态代码确认循环，最后用长度、校验、填充和往返复现建立闭环。这样既能准确恢复算法，也能在公开发布时安全地隐藏真实函数位置、密钥材料和业务样本。</p>

<hr />

<p><strong>工具链接</strong>：<a href="https://github.com/AndroidReverser-Test/trace_search">https://github.com/AndroidReverser-Test/trace_search</a></p>]]></content><author><name></name></author><summary type="html"><![CDATA[]]></summary></entry><entry><title type="html">AI 推动逆向工程工业化</title><link href="https://androidreverser-test.github.io/2026/09/10/ai-industrializes-reverse-engineering.html" rel="alternate" type="text/html" title="AI 推动逆向工程工业化" /><published>2026-09-10T00:00:00+00:00</published><updated>2026-09-10T00:00:00+00:00</updated><id>https://androidreverser-test.github.io/2026/09/10/ai-industrializes-reverse-engineering</id><content type="html" xml:base="https://androidreverser-test.github.io/2026/09/10/ai-industrializes-reverse-engineering.html"><![CDATA[<h2 id="一引子没有-ai-的逆向分析">一、引子：没有 AI 的逆向分析</h2>

<p>先说说在不用 AI 的情况下，一般是如何进行逆向分析的。这里以安卓平台的 native 算法为例。</p>

<p>对于一个足够简单的算法，通常直接用 IDA 静态反汇编、再反编译，看看关键函数的伪代码，就能大致知道算法是怎么实现的；再配合 Frida 等 hook 框架去 hook 关键函数，验证并拿到密钥等信息，算法基本就能复现了。当然，这是 so 既没有混淆、也没有加固时才可行的路子。</p>

<p>但如果遇到强混淆的 so，或者足够复杂的 VMP 加固算法，再想靠静态分析走通恐怕已经很难了。这时比较稳妥的方案，是通过 trace 框架获取所需的指令流，然后分析这些 trace 日志来复现算法。</p>

<p>然而，VMP 加固后的指令流实际上同样非常难分析：经过 VM 的一层转换，一条简单的运算操作都可能演变成几十条 ARM64 汇编指令，分析工作量无疑会暴涨。当然，业界也有污点分析、语义提升这类手段来简化分析过程，但先不说这两者的实现复杂度本身就很高，就算实现了，在纯人工分析的情况下难度依然极大——尤其是面对极度复杂的 VM 实现的算法时，对纯人工分析堪称噩梦级难度。</p>

<h2 id="二ai-来了">二、AI 来了</h2>

<p>自 2025 年以来，AI 开始逐渐进入逆向圈。起初，人们只是以为多了个玩具助手；但随着时间慢慢推进，来到 2026 年初，不少人已经发现这玩意儿绝对不是”玩具”那么简单——到这个时候，AI 的推理能力以及调用 MCP 的能力都得到了极大的提升，越来越多的人开始使用 AI 来承担逆向分析任务，比较热门的玩法有 IDA MCP、Jadx MCP 这些项目。</p>

<p>但直到现在，其实业内还没有形成共识：<strong>我们到底该怎么用 AI 来做逆向分析？</strong></p>

<h2 id="三路线一静态分析--hook-框架验证">三、路线一：静态分析 + Hook 框架验证</h2>

<p>这条路本质上还是以前人工逆向的老思路，只是换成了 AI 来执行。常见的形态是：给 AI 接上 IDA MCP、Jadx MCP 这类工具，让它具备静态分析的能力；再让 AI 通过 <code class="language-plaintext highlighter-rouge">adb shell</code> 或其他手段控制安卓设备，完成安装 hook 等操作——总之，延续的就是上文”人工分析简单算法”的思路。</p>

<p>即便由 AI 来操刀，这类方案其实也只能分析比较简单的算法，对 VM 层的算法依旧难以还原。更何况 AI 目前还容易产生幻觉：很多时候只靠 hook 函数去看参数和返回值、再结合静态分析，是很容易产生误判的。</p>

<h2 id="四路线二trace-流派与-ai-天作之合">四、路线二：Trace 流派——与 AI 天作之合</h2>

<p><strong>Trace 流派才是最适合当前 AI 的工作方式。</strong></p>

<p>当前的 AI，在一个简单、纯粹的环境中才能发挥得最好，而 trace 流派的工作流恰好就足够纯粹——说白了，就是<strong>分析日志、还原算法</strong>。这对 AI 来说就是”读文本 → 推理 → 还原指定算法”，既不用编写 hook 脚本去 hook 指定函数来获取参数和返回值，也省去了一堆操作设备的杂活。可以说，trace 流派和 AI 简直是天作之合，仿佛本来就是为 AI 量身定做的。</p>

<h3 id="41-如何让-ai-以这种方式工作">4.1 如何让 AI 以这种方式工作？</h3>

<p>可以参考<a href="https://bbs.kanxue.com/thread-292139.htm">AI 时代 Native 算法逆向工程的通用思路</a>。简而言之，就是<strong>通过设计合理的 MCP 供 AI 调用</strong>。最简单的形态，是只提供一个”能打开指定文件、并进行搜索和读取操作”的 MCP，让 AI 按需读取需要的 trace 片段来分析算法。</p>

<p>而在真正的实战分析中，还可以额外接入多个 MCP 来提高效率，例如：</p>

<ul>
  <li>接入 <strong>IDA MCP</strong>，直接赋予 AI 静态分析的能力；</li>
  <li>提供<strong>搜索指定内存写入</strong>之类的 MCP，极大提升 AI 的搜索效率。</li>
</ul>

<p>MCP 可以按需接入，但<strong>不可过多过杂</strong>——始终要以分析 trace 日志为主体，不能喧宾夺主。</p>

<h3 id="42-简单混淆还好vmp-加固怎么办">4.2 简单混淆还好，VMP 加固怎么办？</h3>

<p>在分析简单混淆下的简单算法时，直接把原始 trace 片段丢给 AI 是可行的：这种情况下指令流并不复杂，AI 能够轻松识别其中的密码学原语，从而推断出其使用的加密算法。</p>

<p>但经过 VMP 加固的算法就不一样了——指令流会比加固前暴增几十倍。这时再把同样的 trace 逻辑片段丢给 AI，即便 AI 拥有远超人类的分析能力，在高噪点指令的影响下，恐怕也难以分析出具体的算法逻辑。</p>

<p>那这种情况下，如何让 AI 正常完成分析？答案是<strong>语义提升</strong>，可参考<a href="https://bbs.kanxue.com/thread-292297.htm">AI 时代还原 VM 层复杂算法的思路</a>。总而言之：通过语义提升获取所有 handler 的具体语义，据此编写一个解析器，把原始 trace 日志中指定的 handler trace 片段<strong>折叠为等价的一句 VM 指令片段</strong>。折叠后的 VM 指令片段同样包含内存读写、变化的寄存器值等信息。在这种折叠优化之下，AI 便得以”跨越 VM”，直接看到相关 trace 片段的真实语义，从而快速分析出相应的加密方式。</p>

<p>那么问题来了：<strong>如何进行语义提升？</strong></p>

<h2 id="五语义提升从人工苦力到-ai-工业化">五、语义提升：从人工苦力到 AI 工业化</h2>

<p>在过去，要对 VM 的所有 handler 做语义提升，只能人工一个 handler 一个 handler 地啃。且不说容易犯错、产生误判导致语义分析不正确——就算能做到 100% 正确，动辄几百个 handler，要人去逐个分析得花掉多少时间？</p>

<p>但现在不一样了：<strong>AI 来了</strong>。AI 可以不知疲倦地逐个分析每个 handler 的真实语义，还能不断复核；再配合大 trace 样本输入进行验证，用 AI 来做语义提升，准确率已经相当之高。</p>

<p>解决了语义提升的问题，VMP 还有什么能够阻拦 AI 的呢？</p>

<h3 id="51-语义提升到底在做什么">5.1 语义提升到底在做什么</h3>

<p>一句话：<strong>搞清楚每个 handler 到底干了什么，写成语义模板，再让解析器据此把 trace 中成片的汇编折叠回一条 VM 指令。</strong></p>

<p>而判定一个 handler 的真实语义，靠的是”四层证据、交叉验证”：</p>

<table>
  <thead>
    <tr>
      <th>证据</th>
      <th>内容</th>
      <th>地位</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>运行时 trace 片段</td>
      <td>handler 真实执行时读了/写了哪些寄存器槽、值是多少、跳到了哪里</td>
      <td>事实（ground truth）</td>
    </tr>
    <tr>
      <td>IDA 静态反汇编</td>
      <td>操作数取自 IR 的哪个字节、数据宽度、条件码方向</td>
      <td>静态证据</td>
    </tr>
    <tr>
      <td>全量聚合验证</td>
      <td>把语义模板放到千万级块上跑，看值是否全对、有无漏写/多写/跳错</td>
      <td>判决</td>
    </tr>
    <tr>
      <td>语义文档 / facts 生成器</td>
      <td>现成的语义表</td>
      <td>仅为假设，须被前三者校验</td>
    </tr>
  </tbody>
</table>

<p>原则：<strong>不信任任何单一来源</strong>。文档只是假设，trace 与 IDA 是证据，全量验证是判决。</p>

<h3 id="52-实操流程七步-sop">5.2 实操流程（七步 SOP）</h3>

<ol>
  <li><strong>采样</strong>：从全量 trace 中，为每个 handler 类型提取其实际执行过的片段（也可按验证报告给出的行号回取）。</li>
  <li><strong>独立推导</strong>：不看现成模板，只从片段中提取事实——当前 IR 地址、IR 各字节（操作数槽号）、寄存器文件的读写（槽号与值）、VM 内存事件、下一条指令地址——再据此反推运算表达式。例如”写回值 = 读值 « 立即数”，即可断定这是一个移位 handler。</li>
  <li><strong>静态对照</strong>：用 IDA 反汇编 handler，交叉核对操作数位置、宽度与条件码；有分歧时以<strong>指令机器码编码解码</strong>为准（符号名渲染不可信）。</li>
  <li><strong>全量验证</strong>：把语义模板写进解析器，在全量 trace（上千万个块）上验证——每个写事件都要被模板认领且值吻合，不能有幽灵写（模板说写了、实际没写），也不能有漏报（实际写了、模板没认领）。</li>
  <li><strong>分歧仲裁</strong>：出现硬失败，就按失败样本的行号取回片段，结合 IDA 反汇编定位根因（是模板错、还是验证器能力缺口）。</li>
  <li><strong>修复闭环</strong>：修正模板（必须改生成器的覆盖表，不手改生成文件），重新生成、重新构建、重跑全量验证。</li>
  <li><strong>回归收敛</strong>：如此迭代，直到全量验证 <strong>0 硬失败</strong>、跳转差值全部归零、每个分支都有覆盖。</li>
</ol>

<h3 id="53-几条实战经验">5.3 几条实战经验</h3>

<ul>
  <li><strong>单样本会系统性漏检</strong>：条件方向反了、数据宽度错了，在某些数据上可能”恰好成立”，只有全量聚合才暴露。</li>
  <li><strong>验证器本身也要被验证</strong>：求值器的能力缺口（如缺少符号扩展）会制造海量假阳性，修验证器与修模板同等重要。</li>
  <li><strong>一切偏移以指令编码为准</strong>：采信 IDA 符号名推偏移，是实战中唯一一次”越修越差”的根因。</li>
  <li><strong>“省略”必须可证伪</strong>：识别出哑运算（如吸收律 <code class="language-plaintext highlighter-rouge">a &amp; (a|k) ≡ a</code>，写回值恒等于读值，实为 VM 插入的反分析噪声）并从折叠输出中省略时，必须配一条全量反向校验——证明被省略的写确实不改变任何状态，才敢整类删除。</li>
</ul>

<h2 id="六结语">六、结语</h2>

<p>总之，在使用了上述方法之后，AI 已经能够分析极其复杂的 VM 实现的复杂算法。这是一套标准化的作业流程，压根不需要靠人工给予关键指导。</p>

<p>如果说古法是人力小推车，那这套方法，就是逆向分析工业化的小汽车。</p>]]></content><author><name></name></author><summary type="html"><![CDATA[一、引子：没有 AI 的逆向分析]]></summary></entry></feed>